バッチApexでAmazon S3のファイルを読み込む組み立て方
S3のファイルを1件ずつ同期処理で読み込むと、件数が増えたときにコールアウトの回数制限に当たります。一覧取得と個別読み込みを分け、バッチApexに乗せる組み立て方を説明します。
なぜバッチで読み込むのか
S3に置かれたファイルを1つだけ読むなら、ボタン1つの同期処理でも足ります。ですが「バケットの中身をまとめて取り込む」ような場面では、ファイルの一覧を取ってから1件ずつダウンロードする、2段階のコールアウトが必要になります。Apexの1トランザクションで送れるコールアウトは、同期・非同期を問わず最大100回です。件数が増えるほど、同期処理の中でループしてコールアウトを重ねるやり方は限界に当たります。
バッチApexなら、対象を小さな単位(スコープ)に分けてexecuteメソッドを繰り返し呼び出せます。executeが1回呼ばれるごとに、そこで使えるコールアウトはまた最大100回に戻ります。スコープサイズを絞れば、ファイルが増えてもバッチの回数が増えるだけで、1回のexecuteが制限に当たることはありません。
用意するもの
| 用意するもの | 内容 |
|---|---|
| S3バケット | 読み込む元。本記事では example-bucket を使います |
| Salesforce側の認証経路 | S3への発信を許可し署名を作る仕組み |
| 読み込んだ内容の保存先 | Salesforce側の ContentVersion |
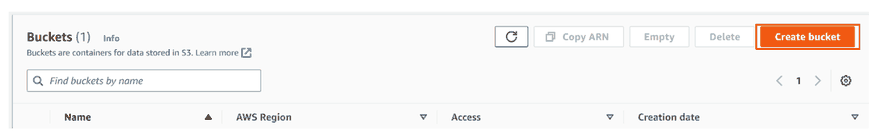
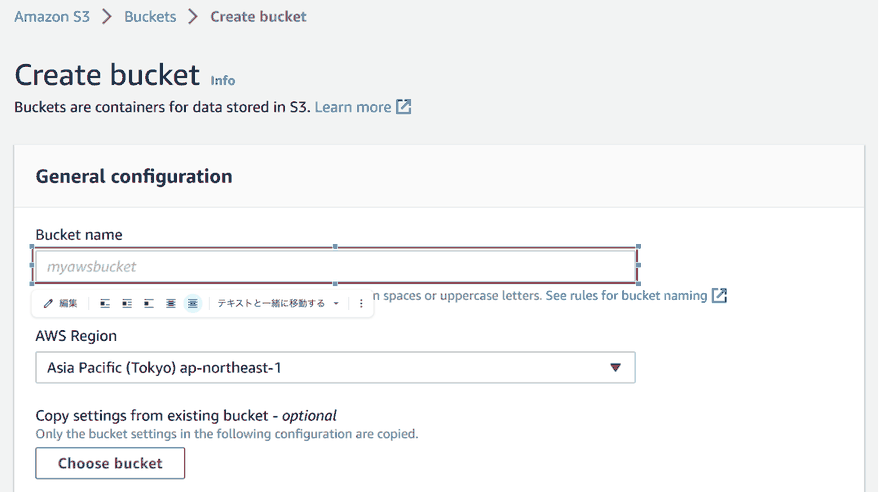

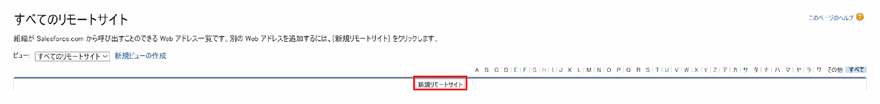
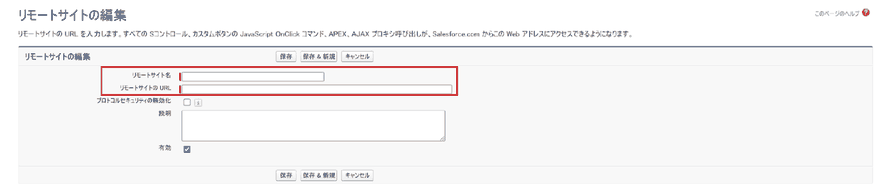
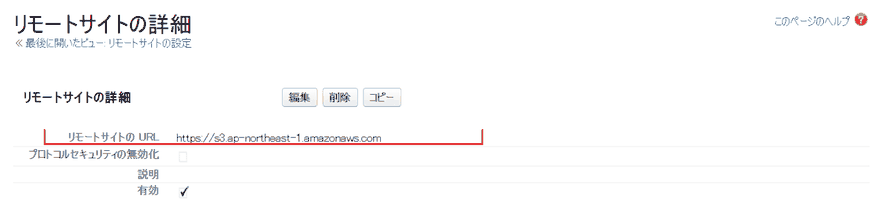
認証経路は、送る側のアップロードと同じ考え方です。現在の公式ドキュメントが勧めているのは、リモートサイト設定ではなく、AWS Signature Version 4に対応した外部ログイン情報と指定ログイン情報の組み合わせです。アクセスキーとシークレットは外部ログイン情報側に保存し、Apexのコードには書きません。以降のコード例では、署名の仕組みを示すために自前でHMAC署名を組み立てていますが、実運用でアクセスキーを文字列としてApexに書く手順はお勧めしません。
BatchableとDatabase.AllowsCallouts
S3のファイル名(キー)の一覧をIterable<String>としてstartメソッドから返し、executeメソッドで1件ずつダウンロードする形にします。バッチApexでコールアウトを送るクラスは、Database.Batchableに加えてDatabase.AllowsCalloutsを実装する必要があります。この実装が無いと、コールアウトを送る行で実行時エラーになります。
public with sharing class S3FileReadBatch implements Database.Batchable<String>, Database.AllowsCallouts {
  public Iterable<String> start(Database.BatchableContext bc) {
    return new S3KeyIterable();
  }
  public void execute(Database.BatchableContext bc, List<String> keys) {
    for (String key : keys) {
      downloadAndSave(key);
    }
  }
  public void finish(Database.BatchableContext bc) {
  }
}
バッチのクラス宣言部分だけを抜き出しています。startとexecuteは後述します
一覧を取ってから個別に読む
startが返すIterable<String>の中身は、バケットへのGETリクエストで取った一覧です。バケット直下へのGETは、オブジェクトの中身ではなく、キーの一覧をXMLで返します。この一覧取得も1回のコールアウトなので、startが呼ばれた最初の段階でまとめて済ませておきます。
String host = 'example-bucket.s3.ap-northeast-1.amazonaws.com';
HttpRequest req = new HttpRequest();
req.setMethod('GET');
req.setEndpoint('https://' + host + '/');
req.setHeader('Host', host);
req.setHeader('Date', Datetime.now().formatGMT('EEE, dd MMM yyyy HH:mm:ss z'));
req.setHeader('Authorization', authHeaderForList);
HttpResponse res = new Http().send(req);
Dom.Document doc = res.getBodyDocument();
バケット直下へのGETでキーの一覧を取得する部分だけを抜き出しています
一覧が取れたら、あとはexecuteの中でキーごとにGETを送るだけです。一覧取得とファイル本体の取得は、URLもレスポンスの形も別物です。一覧はXMLのドキュメント、ファイル本体はバイナリのボディが返ります。

読み込んだ内容をSalesforceに保存する
読み込んだファイルはContentVersionとして保存し、ContentDocumentLinkで取引先などのレコードに紐づけます。
private void downloadAndSave(String key) {
  HttpRequest req = new HttpRequest();
  req.setMethod('GET');
  req.setEndpoint('https://example-bucket.s3.ap-northeast-1.amazonaws.com/' + EncodingUtil.urlEncode(key, 'UTF-8'));
  req.setHeader('Host', 'example-bucket.s3.ap-northeast-1.amazonaws.com');
  req.setHeader('Authorization', authHeaderForKey(key));
  HttpResponse res = new Http().send(req);
  if (res.getStatusCode() != 200) {
    return;
  }
  ContentVersion cv = new ContentVersion();
  cv.Title = key;
  cv.PathOnClient = key;
  cv.VersionData = res.getBodyAsBlob();
  insert cv;
}
1件のキーを読み込みContentVersionとして保存します。読み取ったファイルの中身以外、組織の既存データは変更しません
downloadAndSaveをキーの件数ぶん呼ぶと、DMLもファイルの件数だけ発生します。失敗をキャッチして文字列に貯めるだけでは、失敗した件数がどれだけあったのか後から追えません。バッチのfinishメソッドで、成功・失敗の件数をまとめて記録するところまでが1セットです。
大きいファイルを扱うときの制約
レスポンスのボディをgetBodyAsBlob()で受け取るときも、リクエストと同じ上限がかかります。非同期のバッチApexでは12MBまでです。バッチのスコープサイズを大きくしても、1件あたりのファイルがこの上限を超えていればその1件は読み込めません。大きいファイルが混ざる可能性があるバケットでは、事前にファイルサイズを一覧のレスポンスから確認し、上限を超えるものは別の手段(手動ダウンロードなど)に振り分けます。
ここで間違えやすい
| 間違い | 何が起きるか |
|---|---|
Database.AllowsCalloutsを実装し忘れる | コンパイルは通りますが、コールアウトを送る行で実行時エラーになります |
一覧取得もキーごとのexecuteの中で毎回やり直す | 一覧取得ぶんのコールアウトが余計に発生し、100回の上限にすぐ近づきます |
| スコープサイズを大きくしすぎる | 1回のexecuteで送るコールアウトが100回に迫り、規模を増やすと超えます |
| レスポンスが200以外でも例外にせず処理を続ける | 失敗が黙って握りつぶされ、取り込めなかったファイルに気づけません |
| 一覧取得と個別ダウンロードで別の署名の組み立て方を混同する | 対象のパスが違うため、片方だけ署名が合わず403になります |
確認した環境
- 2026年9月/Salesforce Summer '26(APIバージョン67.0)時点の公式ドキュメントで、バッチApexのコールアウト制限と
Database.AllowsCalloutsの仕様を確認しています
まとめ
- 複数ファイルの読み込みは、一覧取得と個別ダウンロードの2段階に分けます
- コールアウトは1トランザクション最大100回。バッチApexなら
executeが呼ばれるたびに枠が戻ります - コールアウトを送るバッチクラスは
Database.AllowsCalloutsの実装が必須です - 取り込んだファイルは
ContentVersionとして保存し、レコードにはContentDocumentLinkで紐づけます - レスポンスのボディも非同期で12MBまでという上限があり、大きいファイルは別の手段を検討します
参考:当時の画面
記事を最初に書いた当時の画面です。いまの手順と違うところは、各画像の説明に書いています。
Salesforceの導入・運用についてご相談ください
導入前の検討から、お使いの環境の改修・運用、AIとの連携まで承ります。状況を伺ったうえで、進め方をご提案します。